Cada producto de CubePath siempre ha sido accesible de más de una forma. Está el panel, para quien quiere hacer clic. Está la API, para quien quiere programar. Está Terraform, para quien quiere su infraestructura en Git, la CLI para quien vive en la terminal, y el SDK para equipos que construyen su propia plataforma interna encima.
Todas consumen la misma API, porque así está construida la plataforma. El panel es simplemente un cliente más.
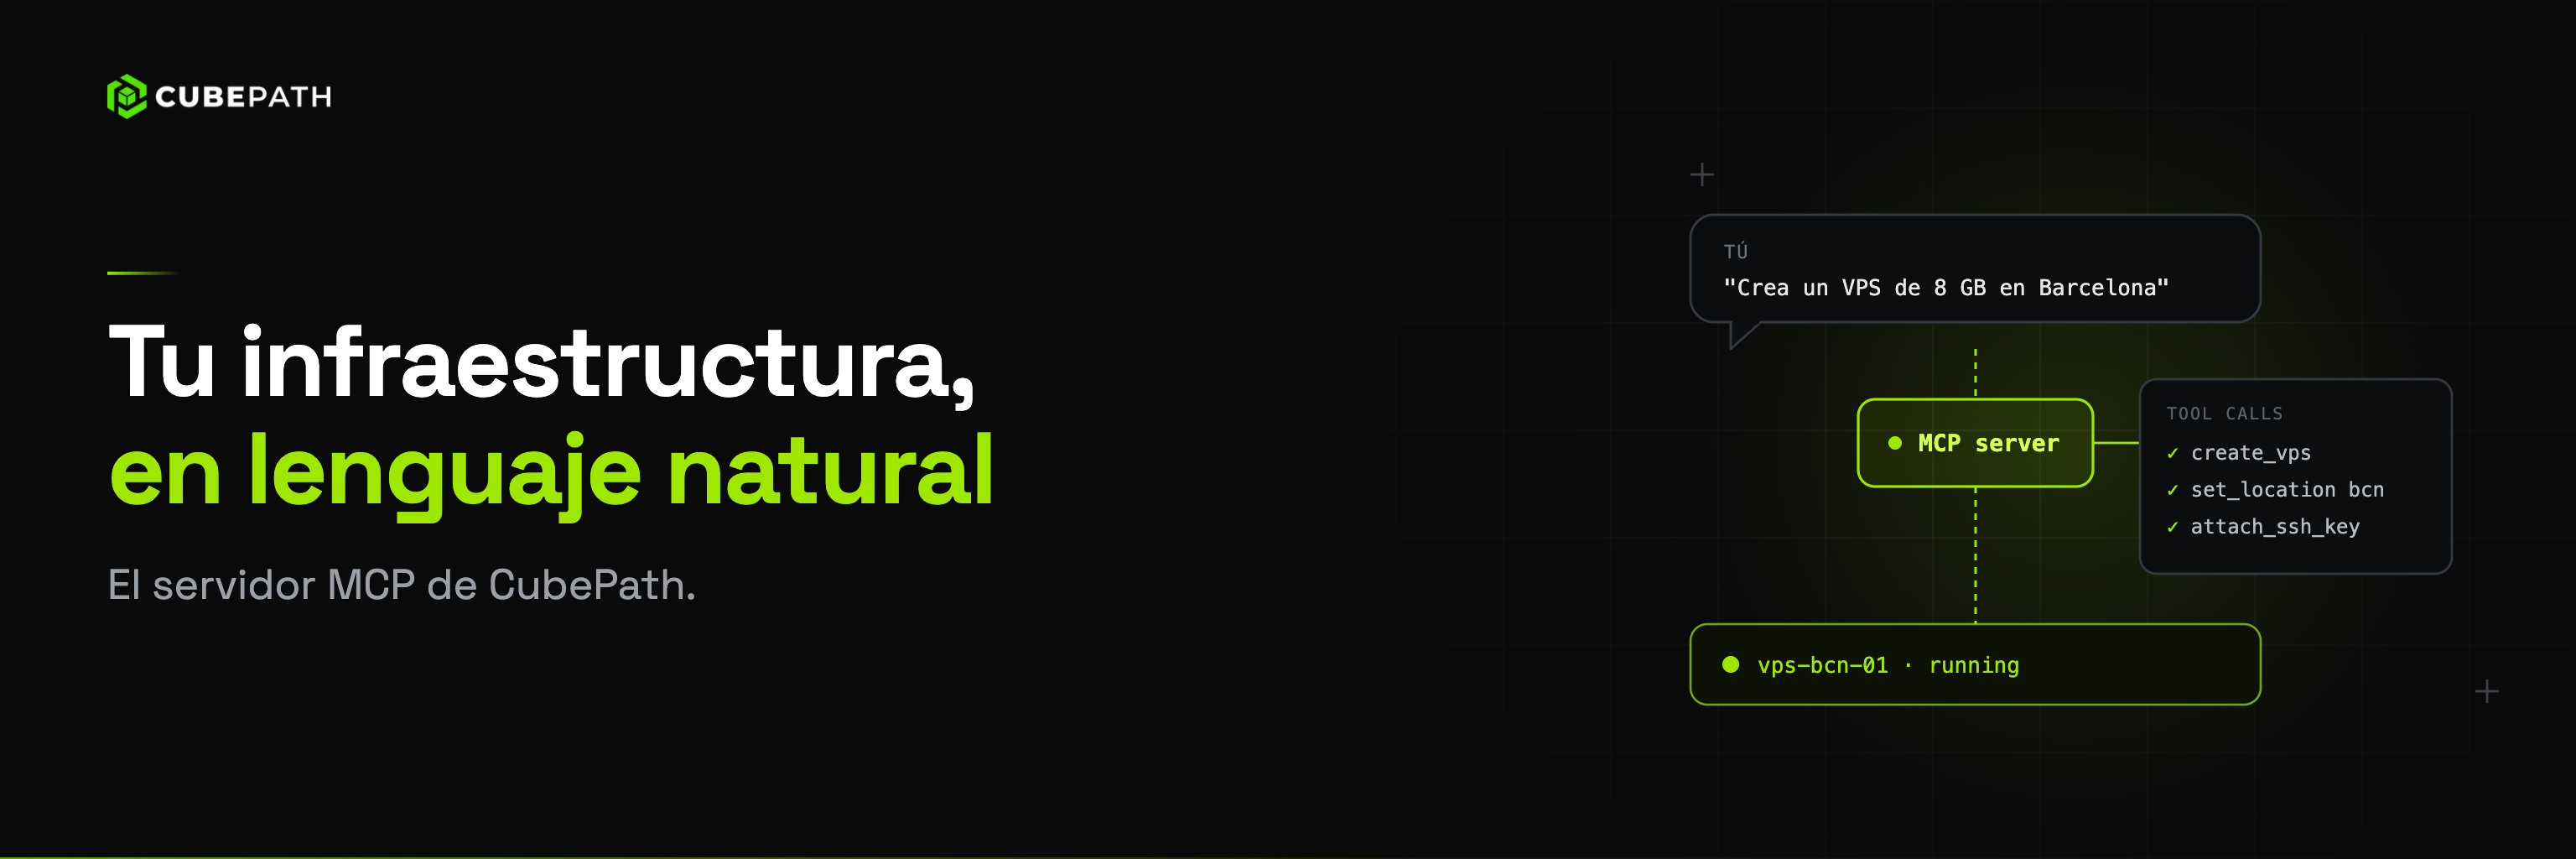
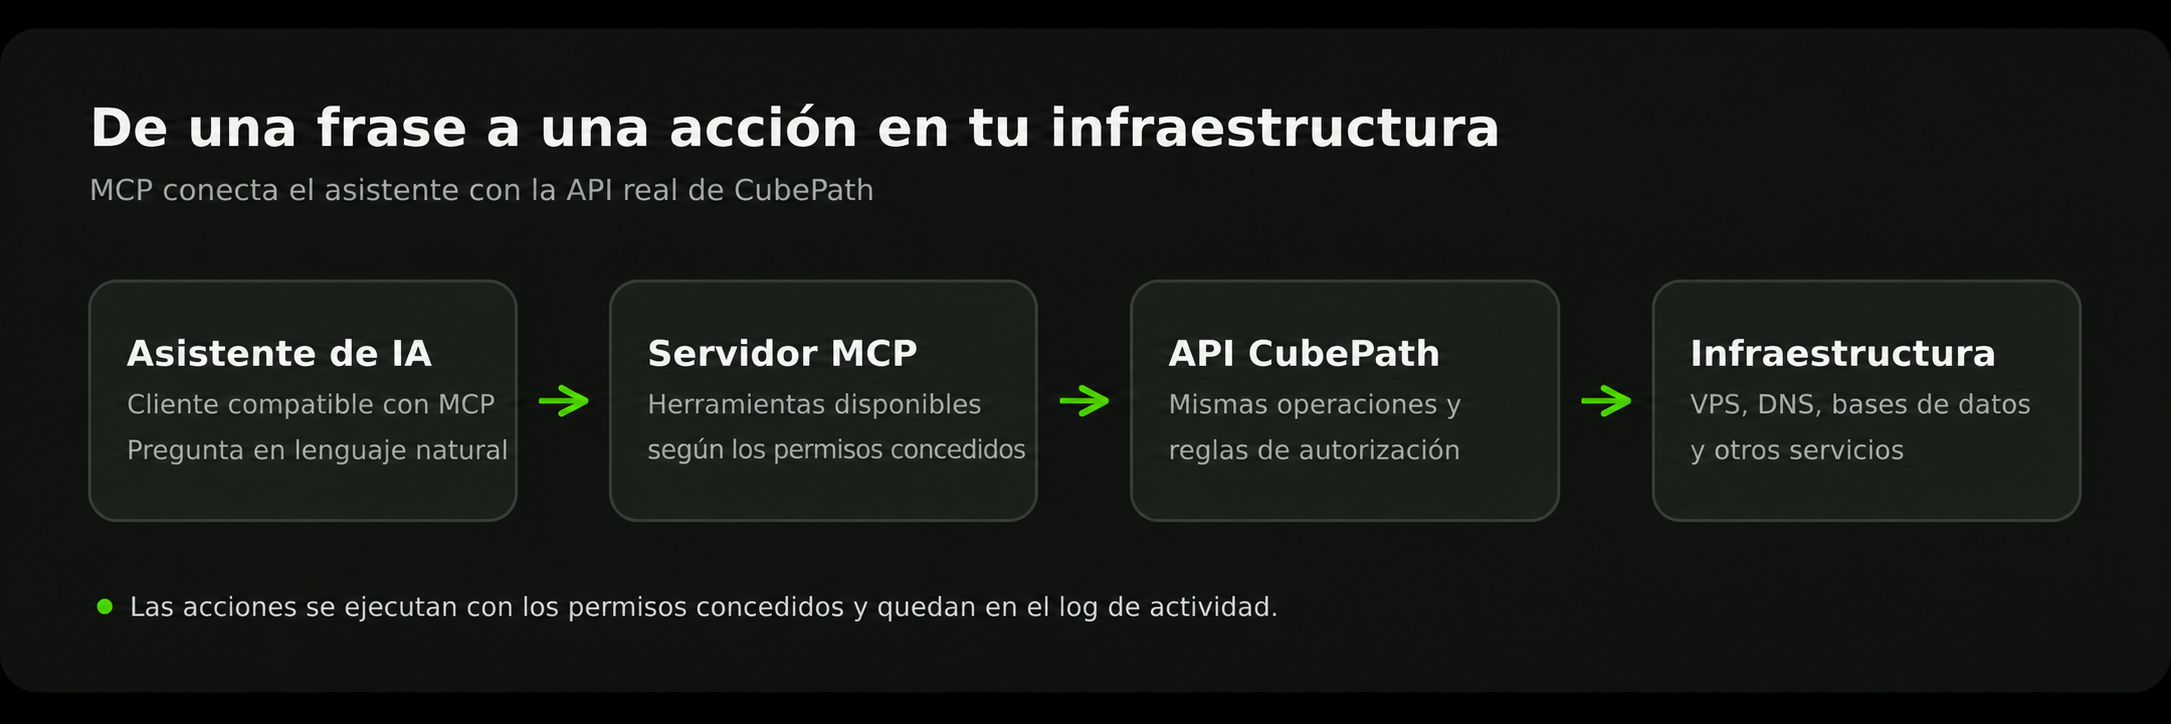
Ahora hay un cliente nuevo, y es de otro tipo: un asistente de IA. CubePath expone un servidor MCP en POST /mcp, lo que significa que Claude Code, cubecli o cualquier cliente compatible con MCP puede operar la infraestructura en lenguaje natural. No es un chatbot que lee la documentación y te dice qué botón pulsar. Es un asistente que llama a la API de verdad, con los permisos que tú le concedes y ni uno más.
Qué Es MCP Realmente
El Model Context Protocol es un estándar para conectar asistentes de IA a sistemas reales. En lugar de que el asistente adivine cómo es tu infraestructura, recibe un catálogo de herramientas que puede llamar, y las llama.
Esa diferencia importa más de lo que parece. Un asistente sin MCP te escribe un curl. Un asistente con MCP puede listar tus VPS, ver que una lleva tres días al 94% de memoria, consultar las métricas para confirmar que no es un pico puntual, redimensionarla y esperar a que vuelva a estar arriba. Cada uno de esos pasos es una llamada real a la API contra tu cuenta, no una sugerencia.
El protocolo es agnóstico al cliente. CubePath implementa el lado servidor, y tú conectas el cliente MCP que prefieras.
Cómo Conectar un Cliente
No hace falta crear ningún token. En Claude Code es un solo comando:
claude mcp add --transport http cubepath https://mcp.cubepath.com/mcp
En claude.ai, añade https://mcp.cubepath.com/mcp como conector. Cualquier otro cliente que implemente el flujo de autorización de MCP funciona igual.
La primera vez se abre el navegador, inicias sesión en CubePath, eliges la organización a la que podrá llegar el asistente y marcas los permisos que le concedes. Ya está. No hay nada que crear antes, nada que copiar y pegar, y ninguna credencial guardada en un fichero de configuración.
Tampoco hay agente que instalar, ni proxy local, ni un servicio aparte que mantener corriendo. El servidor MCP forma parte de la API, está alojado en la misma infraestructura y se accede por HTTPS normal.
El transporte es HTTP stateless: una petición, una respuesta. No hay sesiones que mantener vivas, ni conexiones de larga duración, ni nada que reconectar cuando el portátil se suspende. Reinicia el cliente cuando quieras y la siguiente petición funciona exactamente igual que la anterior.
Lo que el endpoint deliberadamente no acepta es la cookie de sesión del navegador. Un endpoint que despliega y destruye infraestructura a partir de un JSON no debería ser alcanzable desde una página que tengas abierta en otra pestaña.
Sin navegador: token de API
Para los casos en los que no hay navegador que abrir, como un pipeline de CI o un contenedor, puedes usar un token de API en la cabecera X-API-Key:
{
  "mcpServers": {
    "cubepath": {
      "type": "http",
      "url": "https://mcp.cubepath.com/mcp",
      "headers": { "X-API-Key": "<tu token de API>" }
    }
  }
}
Es la excepción, no el camino habitual. Si estás en tu portátil con Claude Code, no lo necesitas.
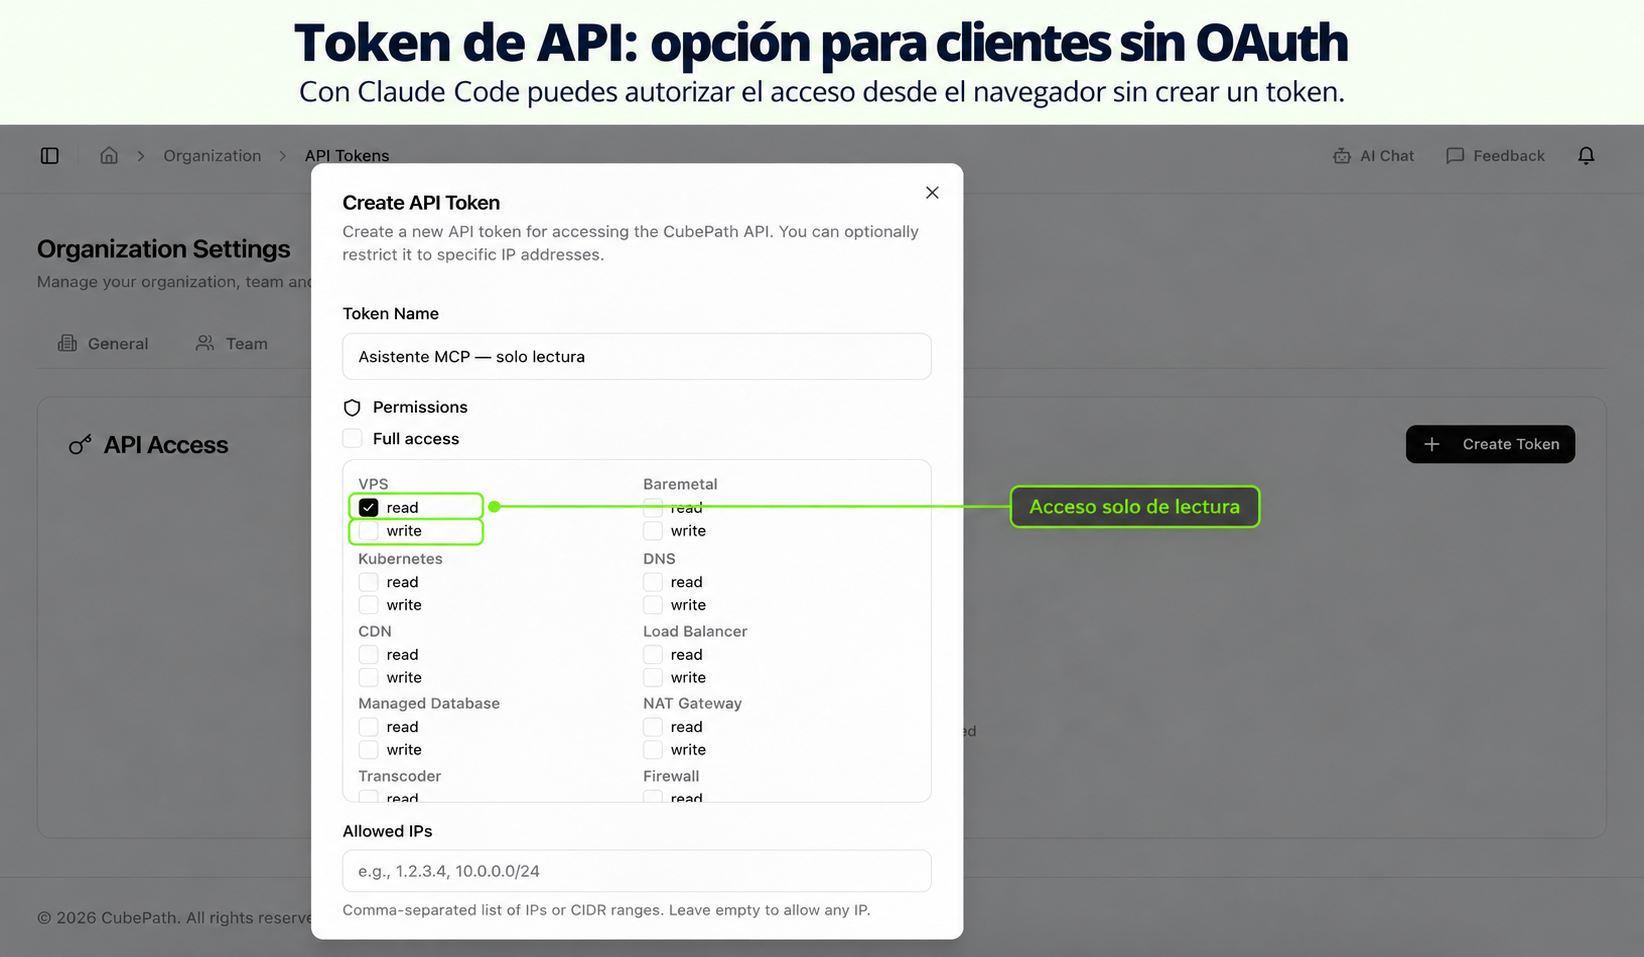
Los Permisos Que Concedes Son el Control Real
Esta es la parte que merece leerse dos veces.
El acceso a la API de CubePath se divide en scopes. Cuando autorizas al asistente en el navegador (o cuando creas un token de API), eliges exactamente qué áreas de producto puede tocar y si puede leer o escribir en cada una: vps:read, vps:write, dns:read, dns:write, kubernetes:read, cdn:write, y así con cada producto de la plataforma.
El servidor MCP aplica esos scopes, con las mismas reglas de autorización que aplica el endpoint REST equivalente. No hay un segundo sistema de permisos, ni un rol específico de MCP, ni nada que configurar dos veces.
Lo que esto significa en la práctica:
Si solo concedes lectura, solo hay herramientas de lectura. No es que "se le pida amablemente al asistente que no cambie nada". Las herramientas de escritura no están en el catálogo que recibe el asistente. No puede llamar a lo que no ve, y si de algún modo lo intentara, el mismo control de scope lo rechazaría.
Pocos permisos, asistente acotado. Concede dns:read y dns:write y nada más, y el asistente se convierte en un asistente de DNS. Tus servidores, tus clusters de Kubernetes y tus zonas CDN no es que estén prohibidos, es que son invisibles. La lista de herramientas se filtra por cada caller.
Tu rol sigue siendo el techo. El asistente nunca puede tener más de lo que tienes tú en la organización, y los permisos se vuelven a comprobar en cada petición contra tu membresía actual. Si tu rol cambia, cambia lo que puede hacer el asistente.
La organización queda fijada. El asistente llega a la organización que elegiste al autorizarlo y no puede saltar a otra.
Las acciones destructivas van etiquetadas. Cada herramienta declara si es de solo lectura, si es destructiva y si es idempotente. Esas marcas llegan al cliente, que es lo que permite a Claude Code parar y pedir confirmación antes de destruir un servidor en lugar de hacerlo a media frase.
La recomendación es simple: en la pantalla de autorización, desmarca todo lo que el asistente no necesite. Puedes conceder menos de lo que pide la aplicación, incluido todo lo que escribe. Para explorar tu infraestructura, probablemente basta con lectura. Y cuando termines, desconéctalo desde Cuenta → Aplicaciones conectadas, donde ves cuándo actuó por última vez cada aplicación. La desconexión surte efecto en su siguiente petición, sin esperar a que caduque nada.
150 Herramientas Sobre Toda la Plataforma
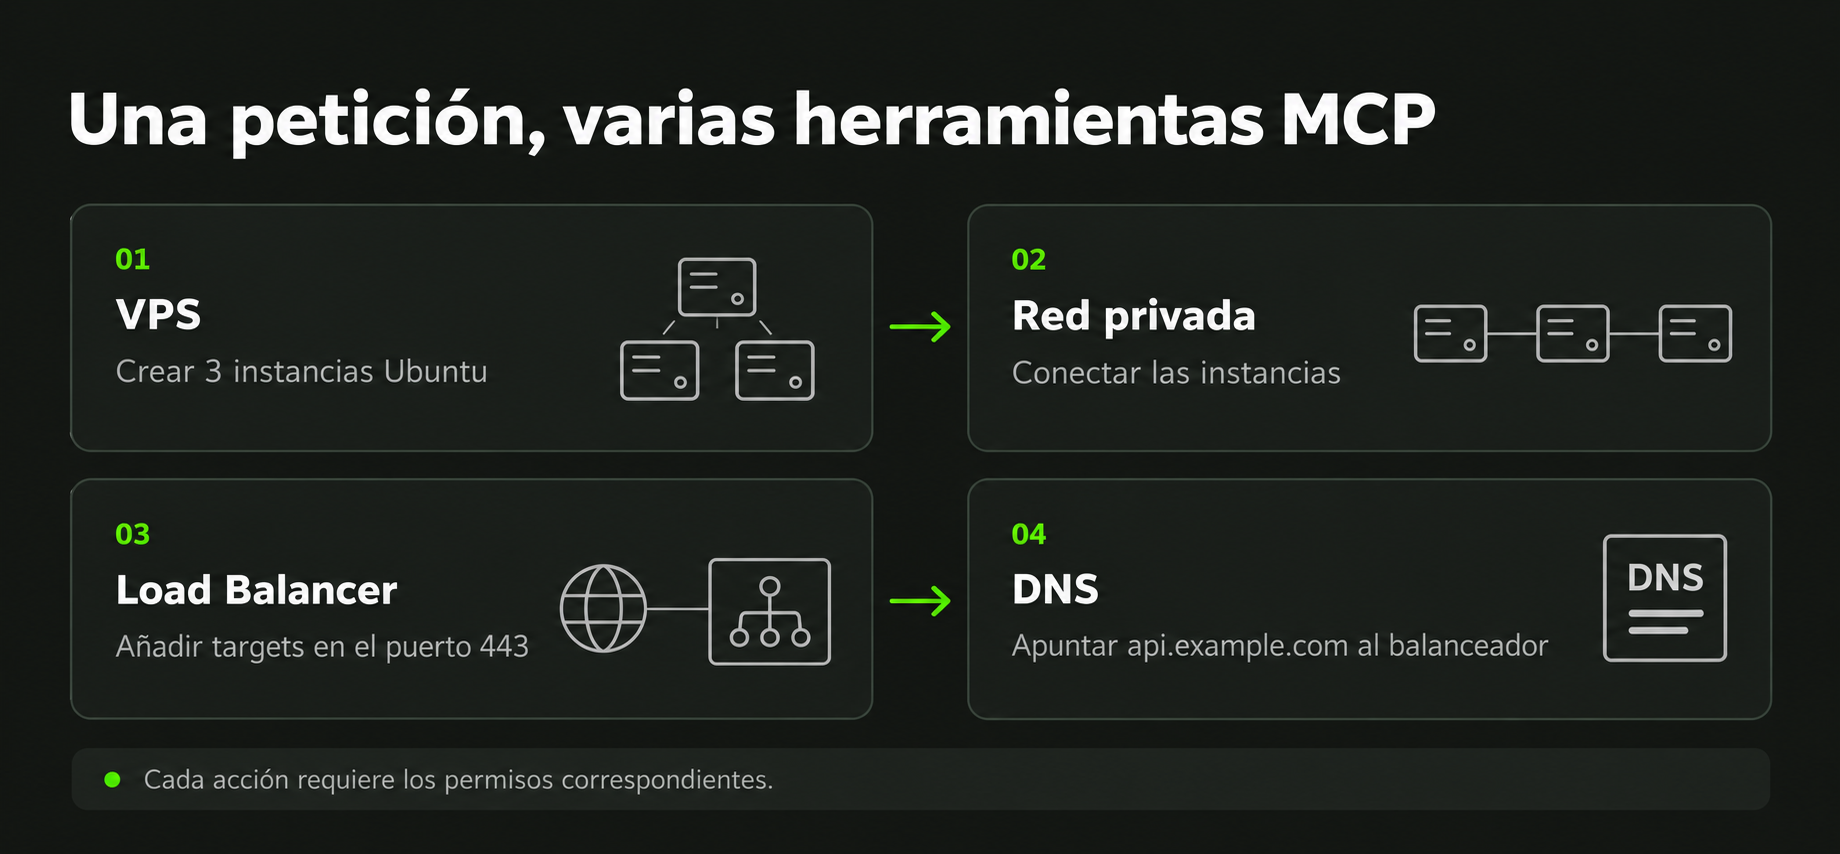
El catálogo MCP no es una demo que cubre un par de endpoints. Cubre toda la superficie de la API orientada a cliente, ahora mismo 150 herramientas agrupadas por área de producto:
- VPS: listar, crear, redimensionar, reinstalar, acciones de energía, backups y restauraciones, snapshots, montar ISO, gestión de claves SSH, conexión a red privada, consumo de ancho de banda, métricas, availability groups
- Bare metal: catálogo, despliegue, energía, reinstalación, modo rescate, sensores BMC, configuración de red, métricas
- Kubernetes: catálogo, creación y actualización de clusters, node pools, instalación y desinstalación de add-ons
- Bases de datos gestionadas: planes, aprovisionamiento, inspección, reconfiguración, bases de datos y usuarios
- DNS: zonas, registros, SOA, regiones GeoDNS, health checks, escaneo y verificación de zonas
- CDN: zonas, orígenes, reglas de caché, URLs firmadas, métricas
- Load Balancers: planes, creación, listeners, targets, métricas
- Networking: redes privadas, peers BGP, NAT gateways, Floating IPs, DNS inverso, túneles
- Seguridad: grupos y reglas de firewall, perfiles de protección DDoS, historial de ataques, consultas de tráfico
- Plataforma: proyectos, claves SSH, Cloud Alerts y canales de notificación, trabajos del transcoder, estado de la red
El compromiso es más estricto que "casi todo está cubierto". Todo endpoint que aparece en la documentación pública de la API o bien es accesible como herramienta MCP, o bien está deliberadamente excluido por un motivo concreto, y los excluidos están listados más abajo. Si ves una operación en la referencia de la API, un asistente puede llamarla.
Cómo Se Ve Esto en la Práctica
Lo interesante no es ninguna herramienta concreta. Es que el asistente puede encadenarlas, y que ya sabe cómo es tu infraestructura porque acaba de leerla.
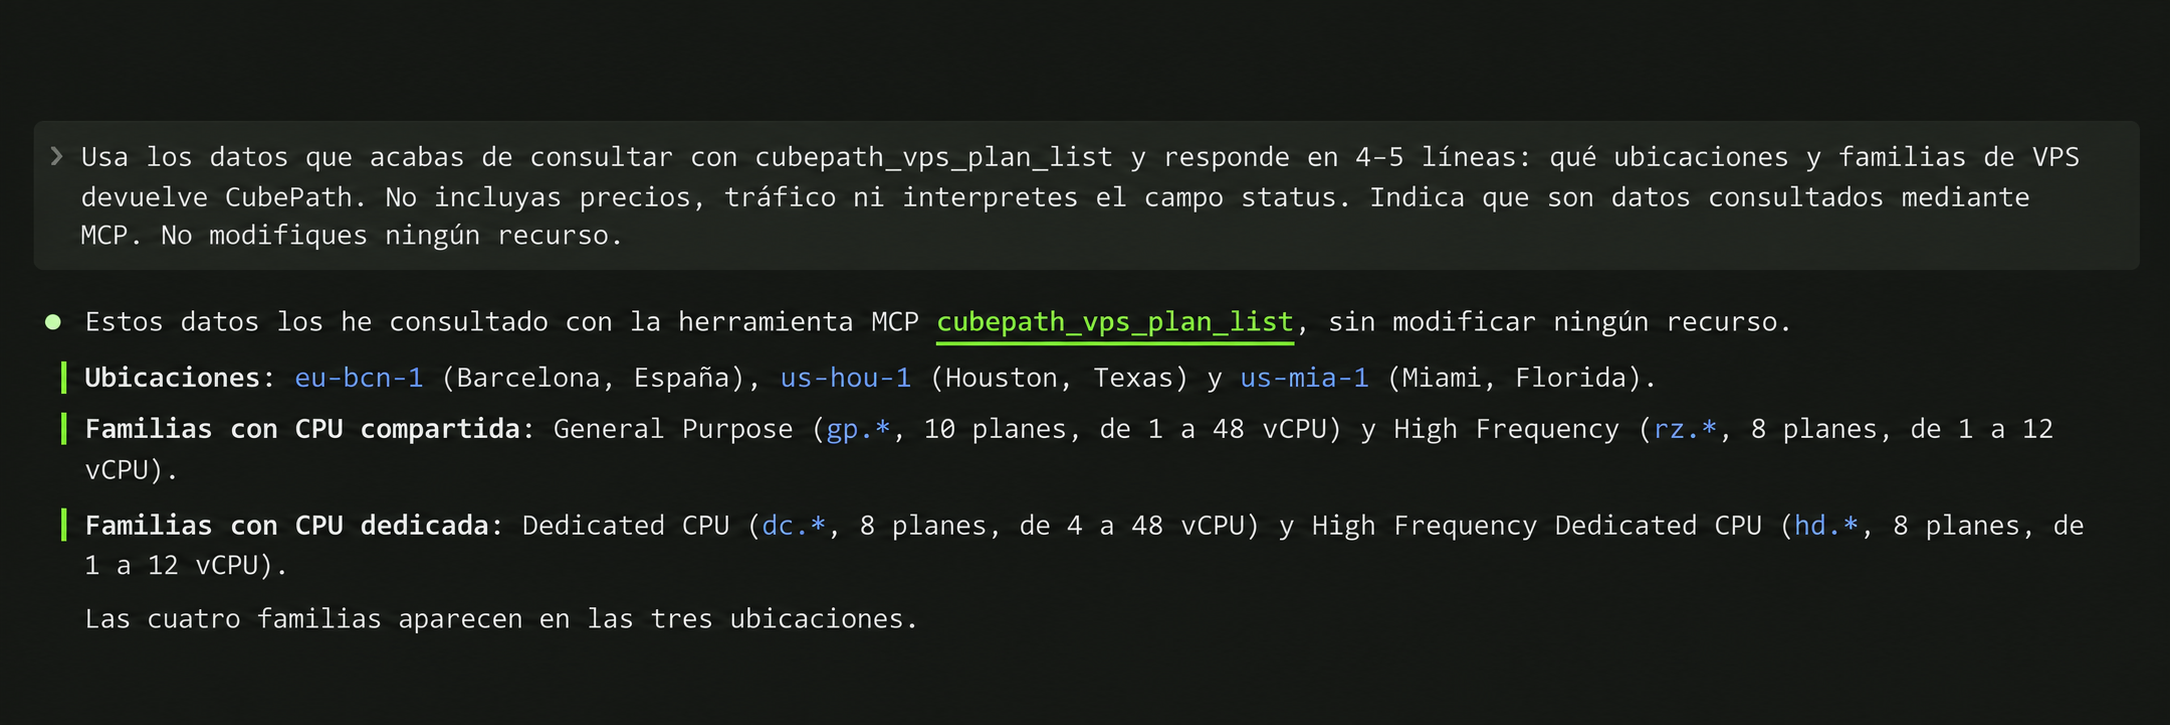
"¿Qué servidores tengo en Miami por debajo del 10% de CPU?" son una llamada de listado más una de métricas por instancia, y luego una comparación. Recibes una respuesta, no un dashboard que interpretar.
"Crea tres servidores Ubuntu en la red privada app-network, ponlos detrás de un load balancer nuevo en el puerto 443 y apunta api.example.com ahí" es una secuencia: crear instancias, esperar a que se aprovisionen, crear el load balancer, registrar los targets, crear el registro DNS. Cada paso es una llamada real a la API, cada una autorizada contra los permisos que concediste, cada una registrada en tu log de actividad exactamente igual que si lo hubieras hecho desde el panel.
"Algo va mal con la CDN, ¿qué ha cambiado?" son un listado de zonas, un listado de reglas y una consulta de métricas, correlacionados en una sola respuesta.
El patrón que más aparece es la investigación. Leer el estado a través de varios productos es tedioso a mano y trivialmente paralelizable para un asistente, y concederle solo lectura lo hace completamente seguro. Habrá equipos que nunca den permisos de escritura y aun así saquen la mayor parte del valor.
Lo Que el Asistente Nunca Ve
Todo lo que devuelve una herramienta acaba en el historial de conversación del cliente. Ese historial se guarda, se sincroniza y a veces se registra en logs. Así que la pregunta de diseño no es solo "¿puede el asistente hacer esto?", sino "¿debería esto acabar escrito en una transcripción?".
Unos cuantos endpoints están deliberadamente fuera del catálogo por ese motivo, aunque son endpoints REST perfectamente normales que tú sí puedes llamar:
- La descarga del kubeconfig de Kubernetes, porque es una credencial de administrador completa del cluster y no se puede revocar por separado
- Las credenciales de bases de datos gestionadas, porque la URI de conexión lleva la contraseña dentro
- El acceso KVM de bare metal, porque devuelve la URL de la consola física y sus credenciales
- La rotación del secreto de token-auth de CDN, porque devuelve el secreto nuevo una sola vez
También hay una capa de redacción que elimina los campos de credenciales conocidos de cada resultado, como red de seguridad. Pero una red de seguridad es lo que es. La defensa principal es no exponer esos endpoints a un asistente, y esa es la decisión que se tomó. Si necesitas un kubeconfig, descárgalo del panel o de la API, donde va a ti y no a un log de chat.
Las respuestas grandes también se recortan antes de devolverse. Una consulta de métricas no vuelca diez mil puntos en la conversación: vuelve como estadísticas más una curva submuestreada, informando siempre del total real, para que una lista truncada nunca se confunda con una completa.
Es la Misma API, No una Copia
Cada herramienta ejecuta la misma operación que ejecuta el endpoint REST equivalente, así que no hay comportamiento que difiera entre las dos vías. Un límite que se aplica cuando creas un servidor desde el panel se aplica cuando lo crea un asistente. Una organización suspendida está bloqueada en ambos casos.
Donde más importa es en el rastro de auditoría. Cuando un asistente crea una VPS, la entrada en tu log de actividad es indistinguible de la que habría escrito el panel, incluyendo qué usuario hay detrás. Conectar un asistente no crea un punto ciego en el registro, y tampoco un segundo conjunto de reglas de permisos que pueda acabar divergiendo del primero.
Dónde Encaja
MCP no sustituye a Terraform, ni lo pretende. La infraestructura de producción debería declararse en código, revisarse en pull requests y aplicarse desde un pipeline. Esa sigue siendo la respuesta correcta, y el provider de Terraform de CubePath sigue siendo la herramienta correcta para ello.
En lo que un asistente es bueno es en todo lo que rodea a eso. Investigar. Responder preguntas que cruzan varios productos y que si no significarían cinco pestañas del navegador. Resolver la tarea puntual para la que nunca va a merecer la pena escribir un módulo. Montar el entorno de staging que vas a tirar el viernes. Hacer la secuencia tediosa de diez llamadas que sabes hacer pero no te apetece hacer.
La forma honesta de plantearlo es que esto es una interfaz más, no una plataforma nueva. La misma API, los mismos permisos, el mismo log de actividad, lo mismo de siempre. Lo que ha cambiado es que el cliente ahora puede ser un asistente, y la instrucción puede ser una frase.
Añade el servidor a tu cliente, concede solo lo que quieras que sea alcanzable y pregúntale qué está haciendo tu infraestructura.