Cualquier aplicación que use modelos de lenguaje en producción acaba en el mismo sitio. Empieza con un proveedor y un SDK. Luego aparece un modelo más barato para el trabajo masivo de resúmenes, así que se añade un segundo proveedor. Luego hace falta un modelo de razonamiento para un camino concreto, y ya van tres. Ahora hay tres API keys en el gestor de secretos, tres cuentas de facturación con tres saldos prepago distintos, tres conjuntos de límites que tener en la cabeza y tres formatos de petición ligeramente diferentes en el código.
Nada de esa complejidad está trabajando para ti. No hace mejor el producto y no abarata los modelos. Es sobrecoste de integración, y crece cada vez que merece la pena probar un modelo nuevo.
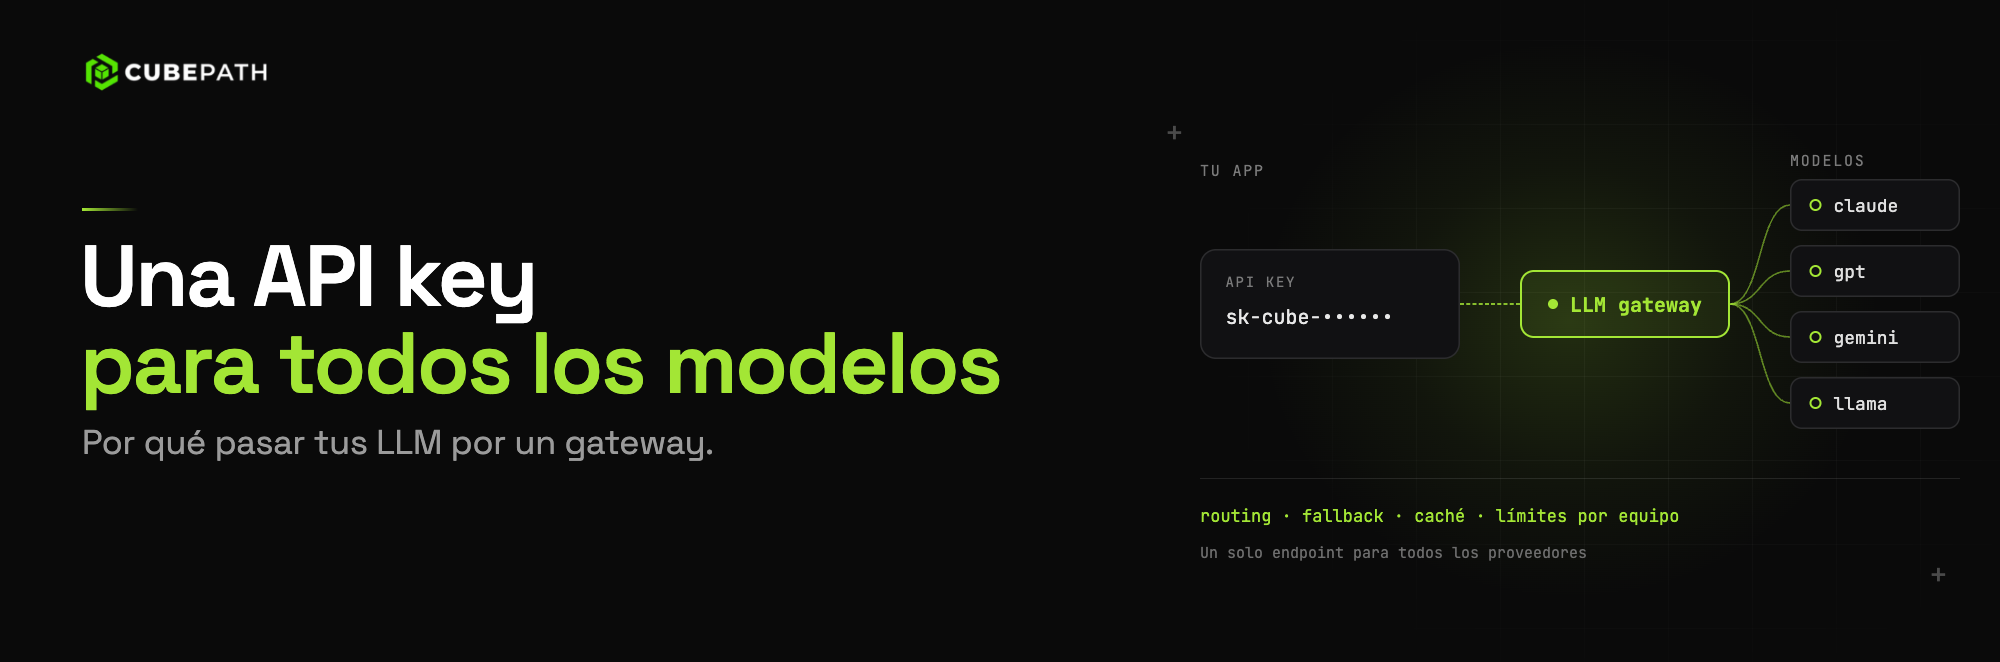
Ese es el problema que resuelve un gateway. Un solo endpoint delante de muchos modelos, una credencial, una factura, un único sitio donde ver lo que has gastado. El AI Gateway de CubePath es nuestra versión de esa idea: se sitúa delante de cinco proveedores y usa el mismo token de API y el mismo saldo que el resto de tu infraestructura.
Este post va de lo que te aporta de verdad esa capa, en lo técnico y en la facturación.
El Impuesto de Integración Que Nadie Presupuesta
El coste de añadir un segundo proveedor de modelos nunca es el coste del modelo. Es todo lo que lo rodea.
Alguien tiene que crear una cuenta de empresa y conseguir que la aprueben. Finanzas tiene que añadir otra tarjeta y otro cargo recurrente que después nadie sabe imputar. Una clave nueva entra en el gestor de secretos y en cada entorno que la necesite. Alguien escribe un adaptador, porque el formato de petición no es exactamente el mismo. Otra persona descubre tres semanas después que ahí el streaming funciona distinto. La lógica de reintentos gana una segunda rama. La observabilidad gana una segunda fuente de verdad. Y cada una de esas piezas tiene que mantenerla alguien, para siempre.
Multiplica eso por tres proveedores y la capa de integración empieza a parecerse a un pequeño producto interno que no genera valor por sí mismo.
Un gateway lo colapsa. La aplicación habla con un endpoint en un formato. Todo lo que hay detrás de esa línea, las cuentas, las credenciales, las diferencias entre proveedores, pasa a ser problema de otro.
Cambiar de Modelo Deja de Ser un Proyecto
El beneficio más concreto es que el modelo se convierte en una cadena de texto en un fichero de configuración.
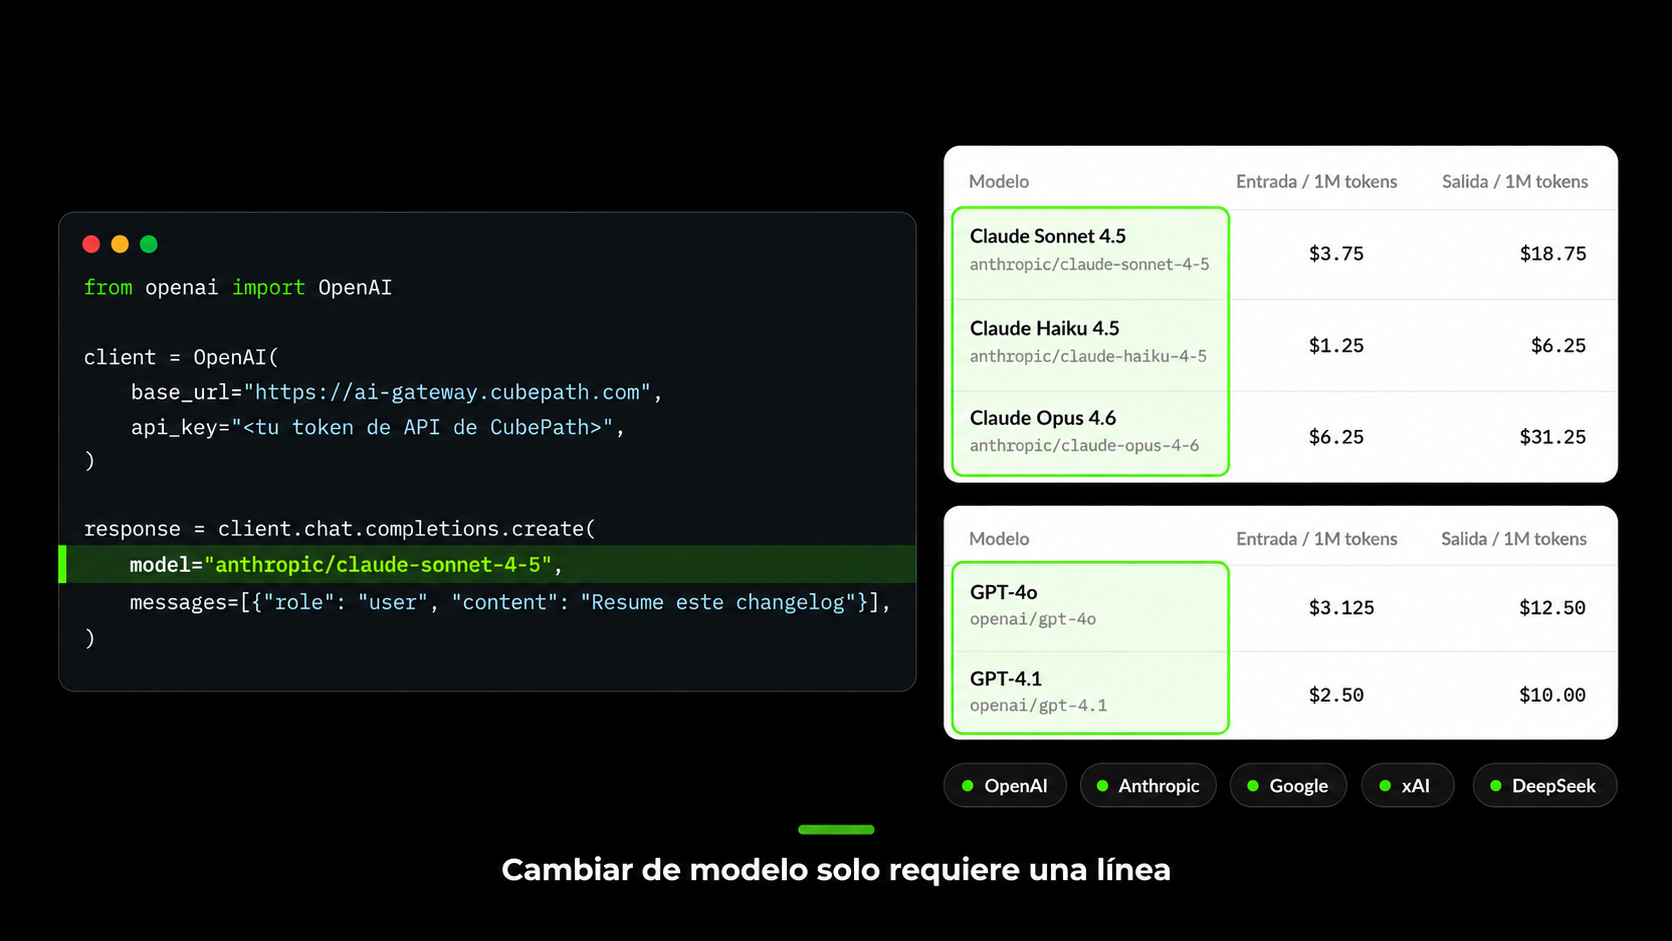
El gateway de CubePath habla el formato de chat completions de OpenAI, así que cualquier librería cliente que ya apunte a OpenAI funciona cambiando la URL base:
from openai import OpenAI

client = OpenAI(
    base_url="https://ai-gateway.cubepath.com",
    api_key="<tu token de API de CubePath>",
)

response = client.chat.completions.create(
    model="anthropic/claude-sonnet-4-5",
    messages=[{"role": "user", "content": "Resume este changelog"}],
)
Los modelos se direccionan como provider/model_id, así que openai/gpt-4.1-mini, anthropic/claude-sonnet-4-5, google/gemini-2.5-pro, xai/grok-4-fast y deepseek/deepseek-chat son alcanzables desde ese mismo cliente. Ahora mismo son 27 modelos entre OpenAI, Anthropic, Google, xAI y DeepSeek, y el catálogo se sirve en vivo: cuando se añade un modelo se puede llamar de inmediato, sin actualizar el SDK y sin desplegar nada por tu parte.
Donde los proveedores sí difieren, la traducción ocurre dentro del gateway. Anthropic y Google no usan el formato de OpenAI, así que las peticiones y las respuestas se convierten en ambas direcciones, streaming incluido. Las llamadas a herramientas, el contenido multimodal, la temperatura, las secuencias de parada y el formato de respuesta pasan por los mismos campos sea cual sea el modelo que acabe atendiendo la petición.
El efecto práctico está en cómo se comportan los equipos, no en cómo queda el código. Cuando probar otro modelo es editar una cadena, alguien lo prueba de verdad. Cuando implica una cuenta de proveedor, una conversación con compras y un adaptador, el experimento simplemente no ocurre y sigues pagando el modelo que elegiste hace dieciocho meses.
Una Factura en Lugar de Cinco
La parte de facturación es donde un gateway se paga solo de formas que es fácil pasar por alto.
Un saldo, no cinco monederos prepago. La inferencia se cobra contra el mismo saldo de organización que paga tus servidores. No hay un monedero de IA aparte que mantener con fondos, ni el riesgo de que un proceso por lotes falle a las 3 de la mañana porque el saldo de un proveedor se agotó mientras los otros cuatro estaban bien.
Sin mínimos ni compromisos por proveedor. Probar un quinto proveedor para un trabajo puntual no significa abrir una quinta cuenta con su gasto mínimo y sus condiciones de pago. El coste de evaluar un modelo baja al coste de los tokens.
Las peticiones fallidas no cuestan nada. Si el proveedor da error, la petición queda registrada para que sepas que ocurrió, y el cargo es cero. No pagas la caída de otro.
Sin descubiertos y sin factura sorpresa. Una petición que tu saldo no puede cubrir se rechaza antes de llegar al proveedor, con un código de estado sobre el que tu cliente puede actuar. Prepago significa que el peor caso es una petición rechazada, no una factura de cinco cifras tres semanas después de un bucle descontrolado.
Sin markup. Lo que pagas por millón de tokens es lo que cuesta ese modelo en su proveedor. El gateway no es un negocio de margen, y el precio actual de cada modelo está publicado en el catálogo para que puedas comprobarlo antes de enviar una petición.
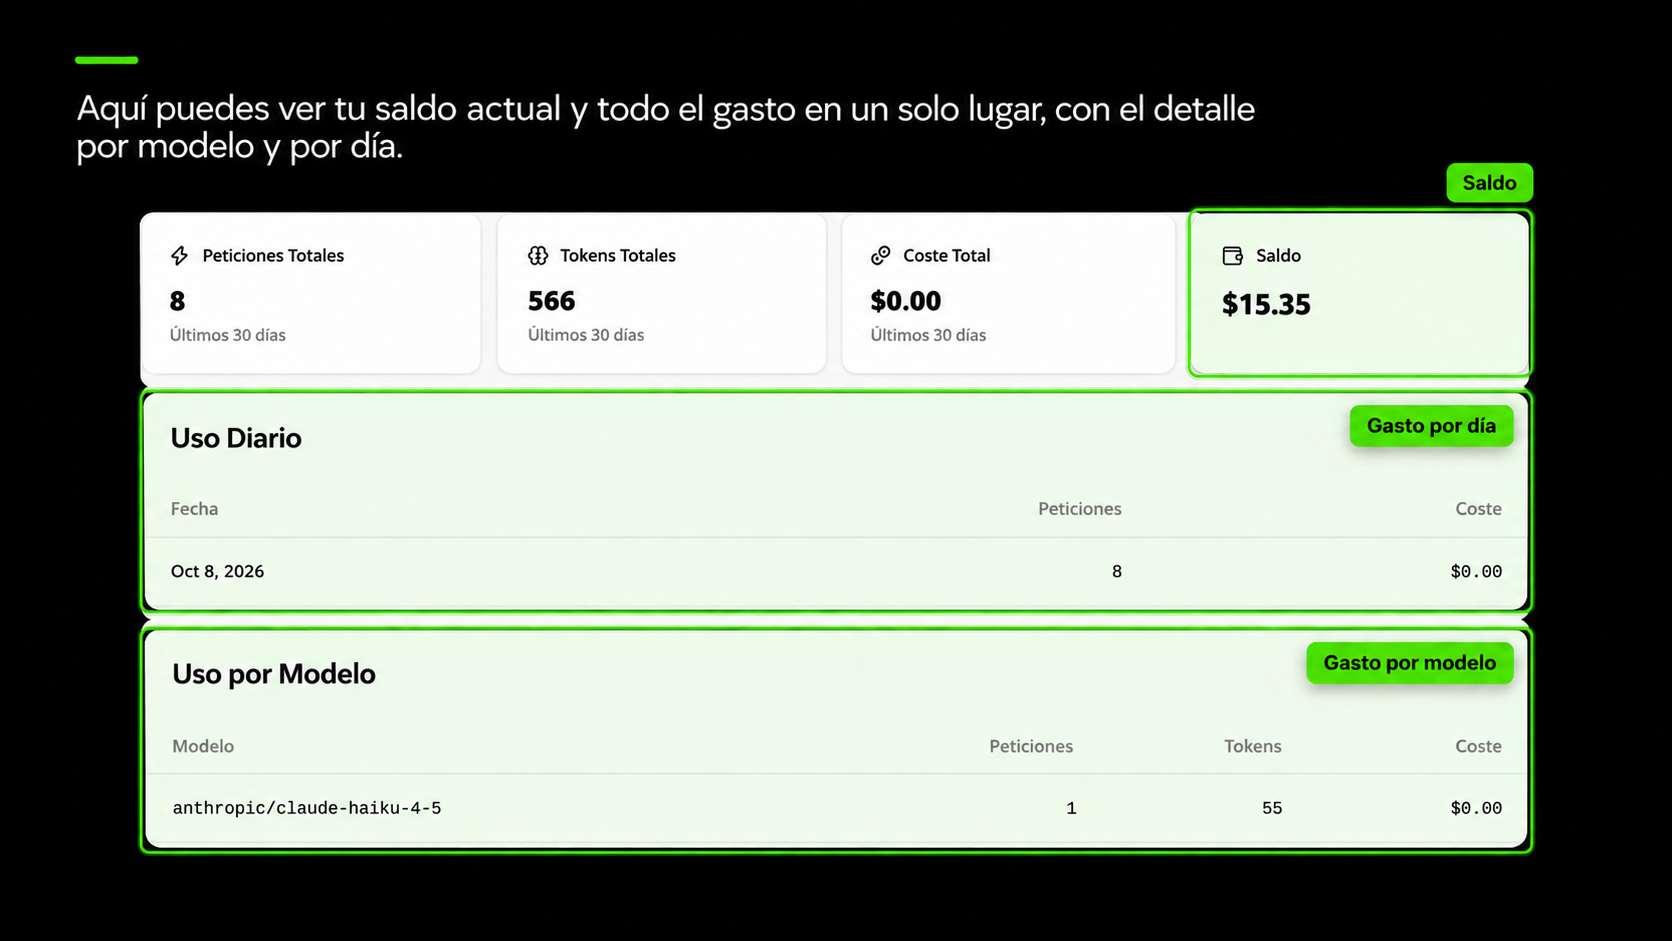
Los costes se llevan con seis decimales, así que una petición que cuesta $0,000042 aparece exactamente así en lugar de redondearse hasta desaparecer.
La Visibilidad del Gasto Es lo Que Más se Infravalora
Pregúntale a casi cualquier equipo cuánto gasta en IA y sabrá responder. Pregúntale qué modelo, qué funcionalidad o qué cliente es el responsable de ese gasto y se hace el silencio. Con cinco paneles de proveedor distintos, esa pregunta es un ejercicio de conciliación que nadie tiene tiempo de hacer.
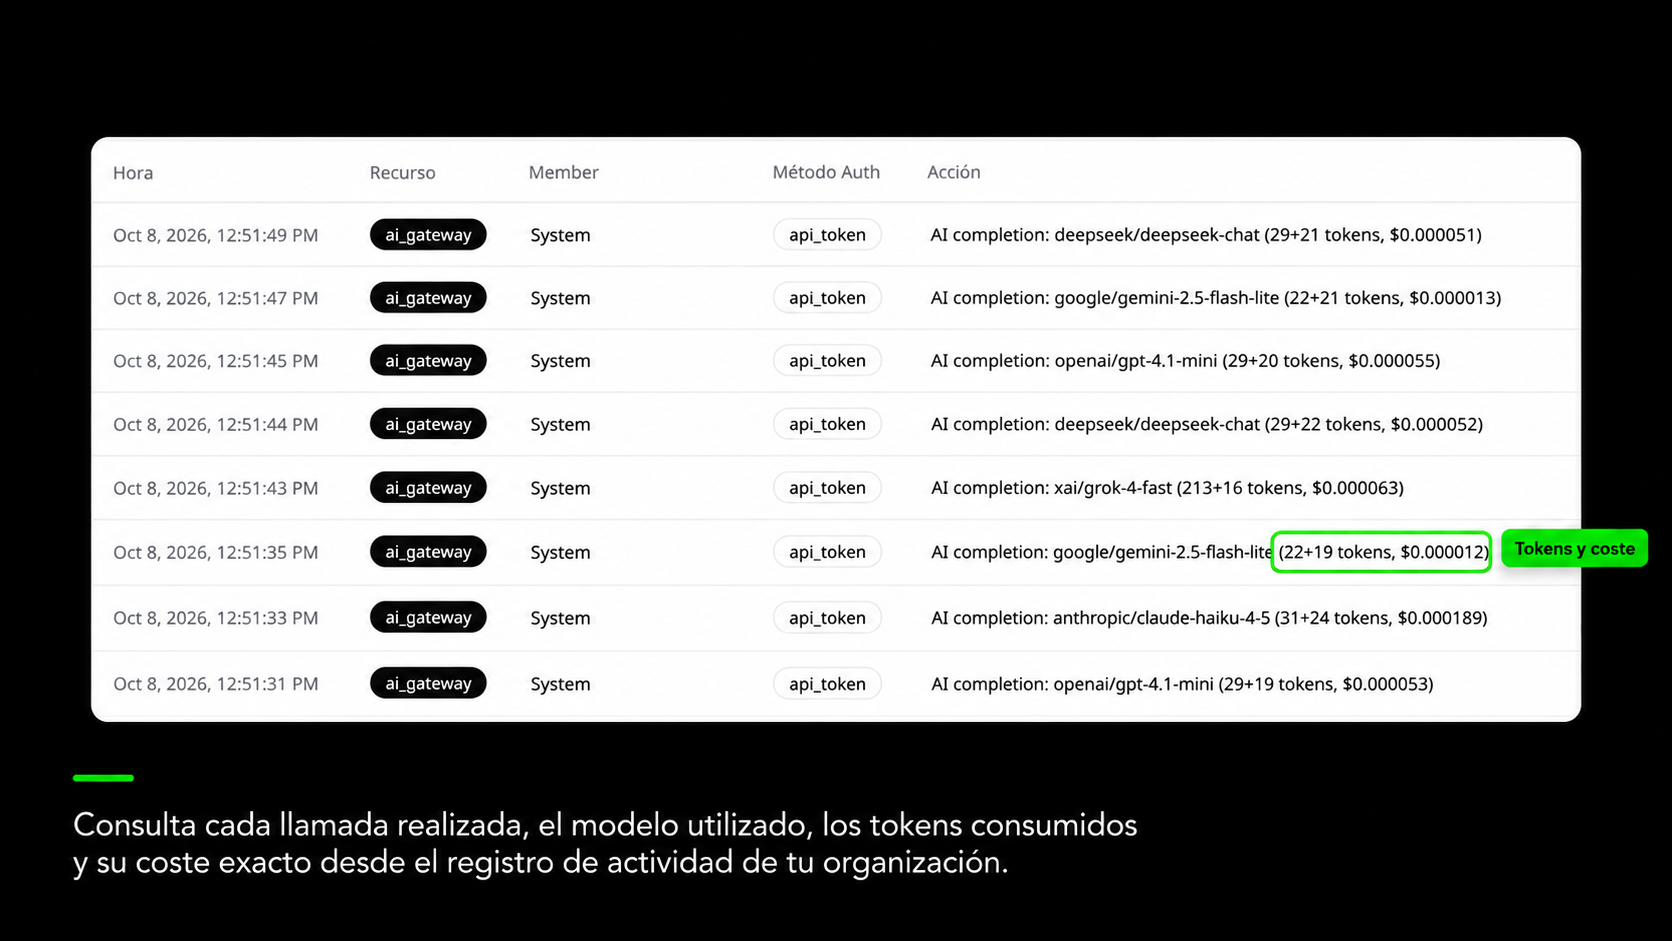
Como todo pasa por un solo sitio, la respuesta simplemente está ahí: gasto por modelo, gasto por día y totales sobre cualquier periodo, en el mismo panel que tus servidores. Cada llamada queda además registrada individualmente con su modelo, sus tokens, su coste, su latencia, su estado y el token y el usuario que hay detrás, y aterriza en el log de actividad de tu organización junto a tus creaciones de VPS y tus cambios de DNS.
Ese dato suele cambiar una decisión en la primera semana. El patrón es casi siempre el mismo: un número pequeño de llamadas de mucho volumen contra un modelo caro, haciendo un trabajo que uno más barato resuelve igual de bien. No puedes actuar sobre eso hasta que lo ves, y no lo ves cuando el gasto está repartido en cinco cuentas.
Una Credencial en Lugar de Cinco
Cada clave de proveedor que tienes es una clave que hay que guardar, distribuir, rotar y en algún momento explicarle a un auditor. Cinco proveedores son cinco de cada cosa, normalmente con cinco procedimientos de rotación distintos y ninguna forma consistente de revocar accesos cuando alguien se va.
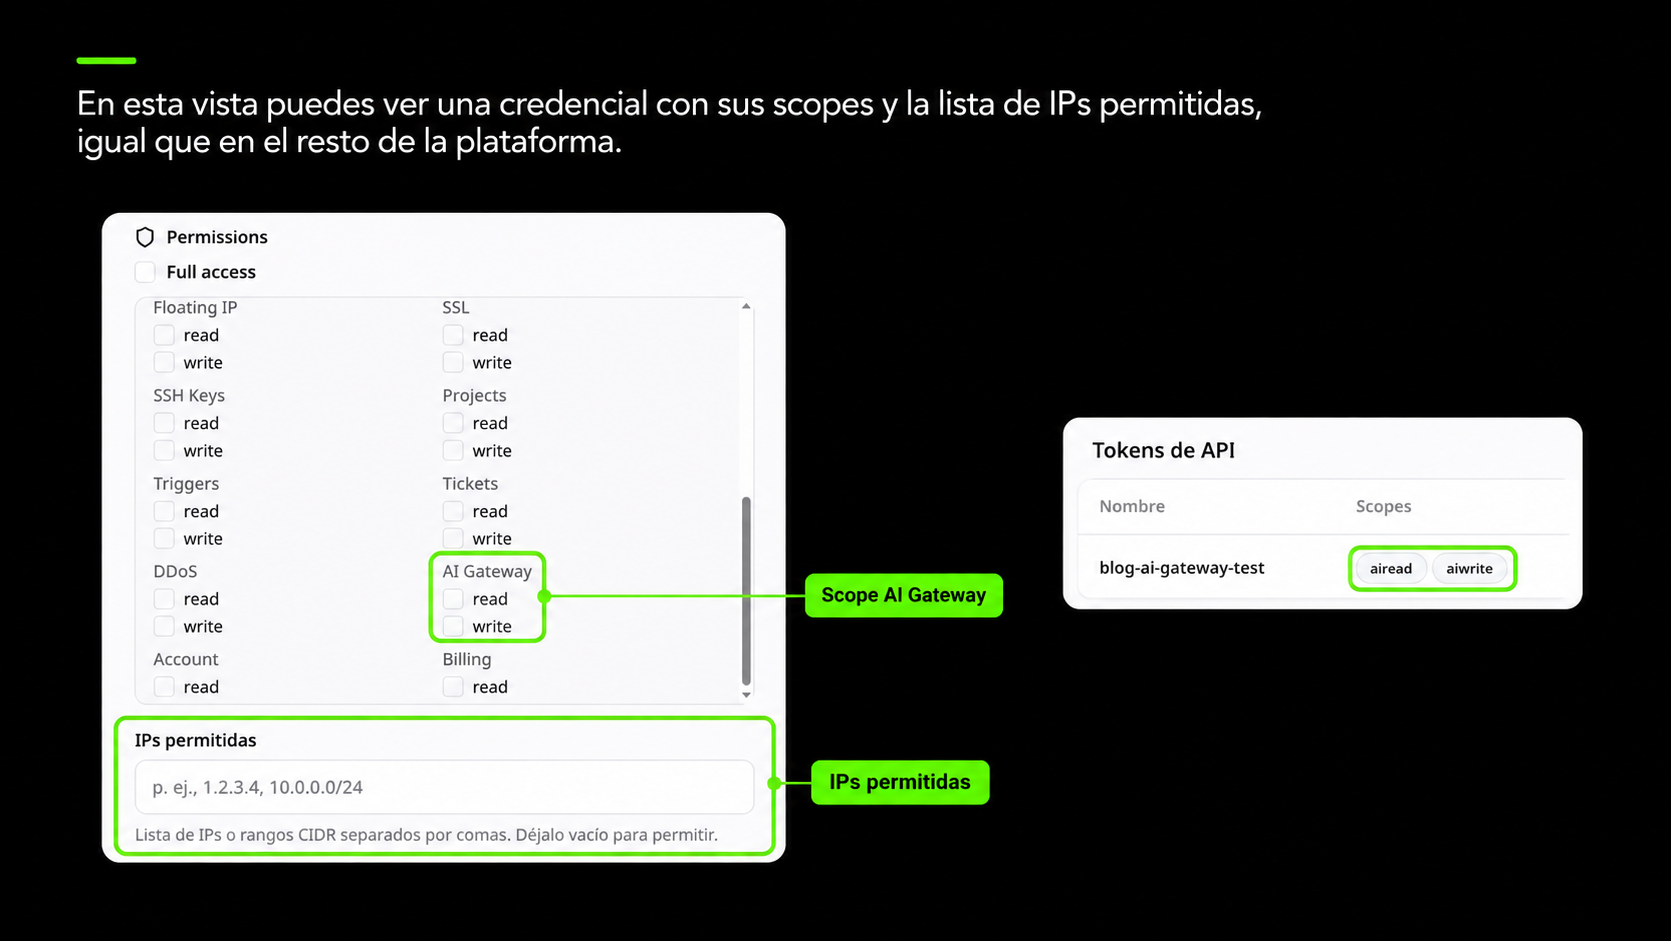
A través del gateway tu aplicación tiene un token de API de CubePath, del mismo tipo que ya usas para la API REST, la CLI o el servidor MCP, y lleva los mismos controles que el resto de la plataforma: scopes que separan leer el catálogo de gastar dinero, una lista de IPs permitidas que rechaza un token filtrado usado desde una dirección inesperada, y un único sitio donde revocarlo.
Las claves de los proveedores se quedan de nuestro lado. No te das de alta en OpenAI, Anthropic, Google, xAI ni DeepSeek, no gestionas sus credenciales y no las rotas. Los errores que devuelve un proveedor se limpian de cualquier cosa que parezca una credencial antes de que los veas, porque los proveedores a veces devuelven un fragmento de clave dentro de un mensaje de error.
Aquí hay un beneficio de gobernanza que en organizaciones grandes suele pesar más que el de ingeniería. El acceso a todos los modelos pasa por una sola credencial que tú controlas, con registro por petición de quién usó qué. Esa es una conversación bastante más fácil que cinco cuentas en la sombra abiertas por cinco equipos.
Failover Entre Proveedores
Este es el beneficio que solo existe cuando hay algo delante de los proveedores, y es el que convierte una integración con un modelo en un componente en lugar de en una dependencia.
Los proveedores de modelos se caen. Y además se degradan, que es peor, porque un proveedor lento en lugar de muerto no dispara tu gestión de errores y simplemente hace que todas las peticiones de tu aplicación tarden ocho segundos. Si tu código habla directamente con un solo proveedor, su mala tarde es tu mala tarde, y no hay nada que hacer salvo esperar y dar explicaciones.
Cuando un proveedor sufre una caída o se le degrada la latencia, las peticiones se enrutan automáticamente a un modelo equivalente de otro proveedor. Tu aplicación sigue respondiendo. Por tu parte no cambia nada, porque el endpoint, la credencial y el formato de respuesta son los mismos sea cual sea el proveedor que acabe atendiendo la petición.
Ese es el tipo de resiliencia que es realmente difícil de construir por tu cuenta. No el bucle de reintentos, que son veinte líneas. Lo difícil es tener ya cuentas y crédito con varios proveedores, saber qué modelo del proveedor B es un sustituto razonable del que pediste en el proveedor A, y detectar la degradación lo bastante rápido como para que el cambio merezca la pena. Son justo las piezas que solo tiene sentido construir una vez, de forma centralizada, en lugar de en cada aplicación que llama a un modelo.
Esa misma propiedad te protege en lo comercial. Un proveedor que cambia condiciones, deprecia un modelo o sube precios es un cambio de configuración por tu parte, no una migración. Esa es la definición práctica de no estar atado.
Dónde Encaja
El argumento a favor de un gateway no es que haga algo que no podrías hacer tú. Es que la alternativa que construirías no tiene ninguna ventaja. Nadie ha ganado nunca un cliente porque su capa de abstracción de proveedores estuviera bien factorizada.
Lo que recuperas es opcionalidad. Cinco proveedores alcanzables desde un endpoint, una credencial con los scopes y la lista de IPs que ya usas en el resto, un saldo que se descuenta por petición, y un sitio que responde a dónde fue el dinero. Probar un modelo nuevo pasa a ser una decisión que tomas un martes por la tarde en lugar de un trimestre que planificas.
Esa última parte es la que compone. Este campo se mueve lo bastante rápido como para que el modelo que deberías estar usando dentro de seis meses probablemente todavía no exista. Poder moverte a él sin una migración vale más que cualquier elección concreta de modelo que hagas hoy.